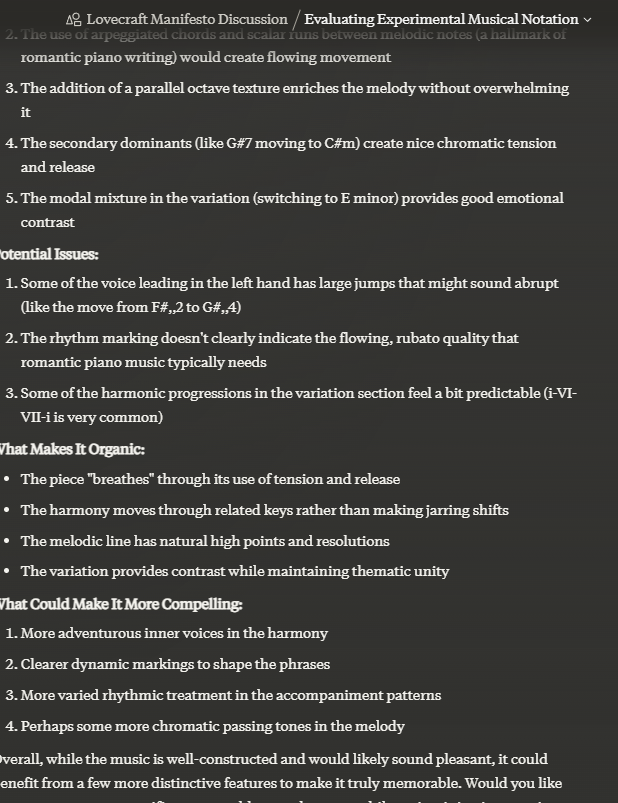
Dieu que c’est intéressant !
Bon, voilà ce que je faisais jusqu’à 3h du matin.
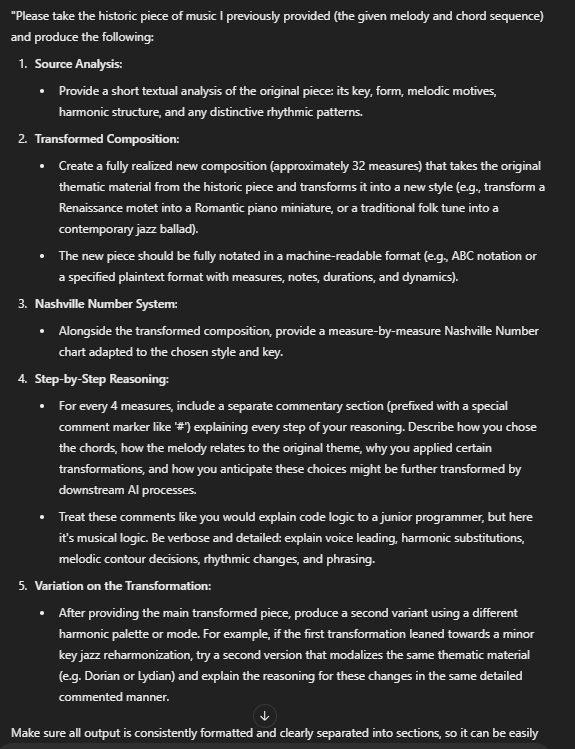
Le prompt initial que j’avais pondu n’a pas marché. Ça a embrouillé la machine et ça a sorti des compositions nulles. C’est pas grave. Ce genre de truc marche rarement du premier coup. J’ai passé le prompt dans Claude et ChatGPT 1o, et j’ai discuté de l’objectif, de la méthodologie de test et du résultat voulu avec les deux.
Et j’ai laissé Claude et ChatGPT 1o trouver chacun leur solution au problème. La solution de Claude a produit des discussions musicales plus riches, mais l’approche de ChatGPT 1o a systématiquement donné une meilleure notation entre les deux modèles. Intéressant.
Le prompt qui fonctionne actuellement est en capture d’écran ici.
La longueur de composition qui semble le mieux marcher entre les deux modèles, c’est 3 pièces par session. Je vais donc m’en tenir à ça.
Évaluation croisée entre modèles
Une fois que j’ai un morceau transformé, la magie opère vraiment avec l’approche d’évaluation croisée ou de jury : on passe la nouvelle compo d’un modèle à l’autre pour examiner des points comme le rendu organique ou l’intérêt musical des compositions.
On note sur quelques critères clés.
1. Les bases techniques de la théorie musicale
2. Le caractère novateur et réfléchi des compos transformées
3. Un score subjectif de « fun » entre 1 et 6, évalué selon la perception d’un public contemporain théorique et non académique !
La critique nous donne aussi un autre point de donnée super intéressant pour l’entraînement, auquel je n’avais pas pensé.
Au bout du processus, on se retrouve donc avec 4 points de données clés :
1. Le morceau original du domaine public.
2. Un document de transformation comprenant trois adaptations de la musique dans des genres entièrement nouveaux, rédigé comme le ferait un compositeur virtuose recourant à des genres, des styles et des techniques modernes, avec des notes d’interprétation et une décomposition.
3. L’analyse et la critique de ces pièces avec des révisions conçues pour repérer les angles morts, corriger les choix inattendus ou qui sonnent faux, et l’explication du POURQUOI et du comment la composition devait être retouchée.
4. Les compositions musicales révisées avec des modifications qui corrigent et s’appuient sur le raisonnement initial de la révision.
Ce que l’expérience m’a appris
Alors, on a appris quoi ?
1. Je crois que je me suis un peu emballée sur les types de notations que je voulais que la machine génère en même temps. C’est un sacré défi, peu importe comment on le voit, et on doit rester un peu plus focalisés sur les types de notation. La prochaine fois, on vire la tablature et la notation Nashville, et on fera ça dans une session séparée.
2. Maintenant qu’on a pigé comment fonctionne le système de notation, on doit ajuster le prompt initial pour qu’il colle aux critères d’évaluation et produire un résultat plus cohérent.
3. Deux machines de raisonnement synthétique qui s’évaluent mutuellement, c’est mieux qu’une seule.
4. On a toujours besoin d’un test de cohérence, donc je vais solliciter tous mes amis compositeurs pour une revue humaine de ces sorties et de ces hypothèses. D’ailleurs, si vous voulez m’aider, je suis preneuse de toutes les paires d’yeux musicalement lettrées possibles.