天哪,这太有意思了!
好,交代一下我凌晨三点前都在干什么。
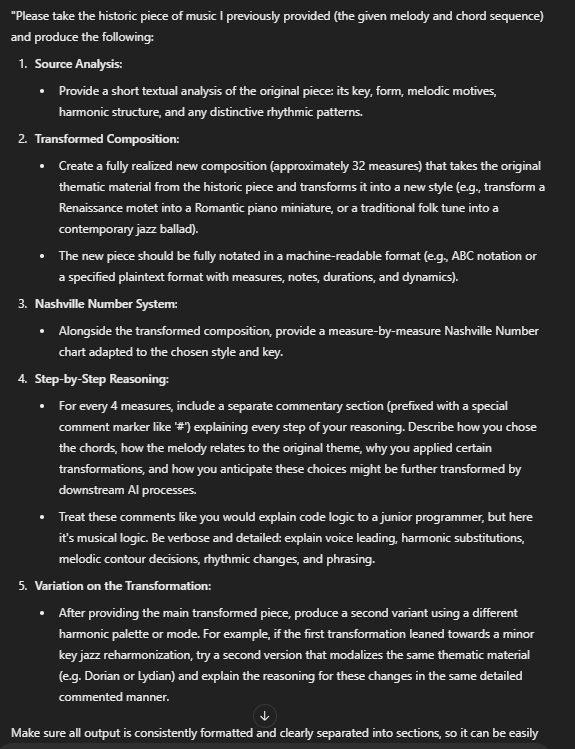
我最初想出的那个提示词没成。它把机器搞糊涂了,产出的编曲也很糟。没关系。这种事很少能一步到位。我把提示词同时喂给 Claude 和 ChatGPT 1o,跟它们俩分别讨论了目的、测试方法和想要的结果。
然后我让 Claude 和 ChatGPT 1o 各自拿出一个能用的方案。Claude 的方案产出的音乐讨论更好,但 ChatGPT 1o 的路子在两个模型之间稳定地产出更好的乐谱。有意思。
眼下能用的提示词截图在这里。
两个模型之间效果最好的曲目长度,是每轮三首。那就定这个了。
模型之间的同行评审
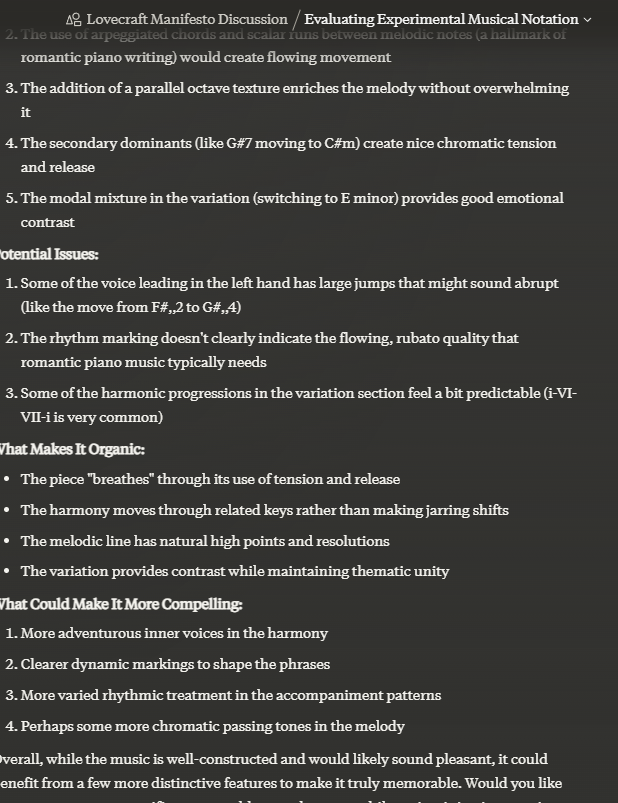
拿到一段改编后的音乐,真正的魔法在同行评审或陪审团这一步:把新作品从一个模型递到另一个手里,让它评审一些东西,比如听起来够不够 organic,编曲在音乐性上够不够有意思。
我们按几个关键标准打分。
1. 乐理上的技术根基
2. 改编作品有多新颖、多走心
3. 一个主观的「好玩」分,1 到 6 分,评分基准是对一个理论上的非学院派当代听众的理解!
这份批评还附赠了一个我压根没想过、但非常适合拿来训练的数据点。
所以走完整个流程,我们手里有 4 个关键数据点:
1. 原始的公有领域音乐。
2. 一份改编文档,包含该音乐三个全新的体裁改编,写得像一位用现代体裁、风格和技巧搞创作的大师级作曲家,带演奏笔记和拆解。
3. 对这些作品的分析与批评,附修订,用来找出盲点、矫正那些出乎意料或听感不 organic 的选择,并解释为什么以及如何需要修改编曲。
4. 修订后的音乐作品,其改动建立并修正了最初的修订理由。
这个实验教会我的
所以我们学到了什么?
1. 我想我对让机器同时生成多少种乐谱这件事,有点贪心了。不管怎么切,这都是高难活,乐谱种类得收一收。下一轮,砍掉 tablature 和 Nashville 记谱,放到单独一轮里做。
2. 既然评分系统已经摸清了,就得回头调初始提示词去对齐评分标准,这样产出才更一致。
3. 两台合成推理机互相评审彼此的作品,胜过一台。
4. 还需要一道人工校验,所以我准备去找我所有作曲家朋友,请他们对这些产出和假设做人工评审。顺带说一句,如果你愿意搭把手,懂音乐的眼睛我有多少要多少。